从九月起,我开始去斯坦福的食堂吃饭。
想去吃饭,就得先知道菜单是什么样的。但是斯坦福提供的菜单网站,还停留在 20 年前,用起来非常难受。一次只能看一个餐厅的一顿饭,想横向对比一下,就得点来点去,重新选一遍。而且有时候看着看着就忘了上一家有什么,还得回去重新看。
我第一次用完,就觉得这个网站非常难用。
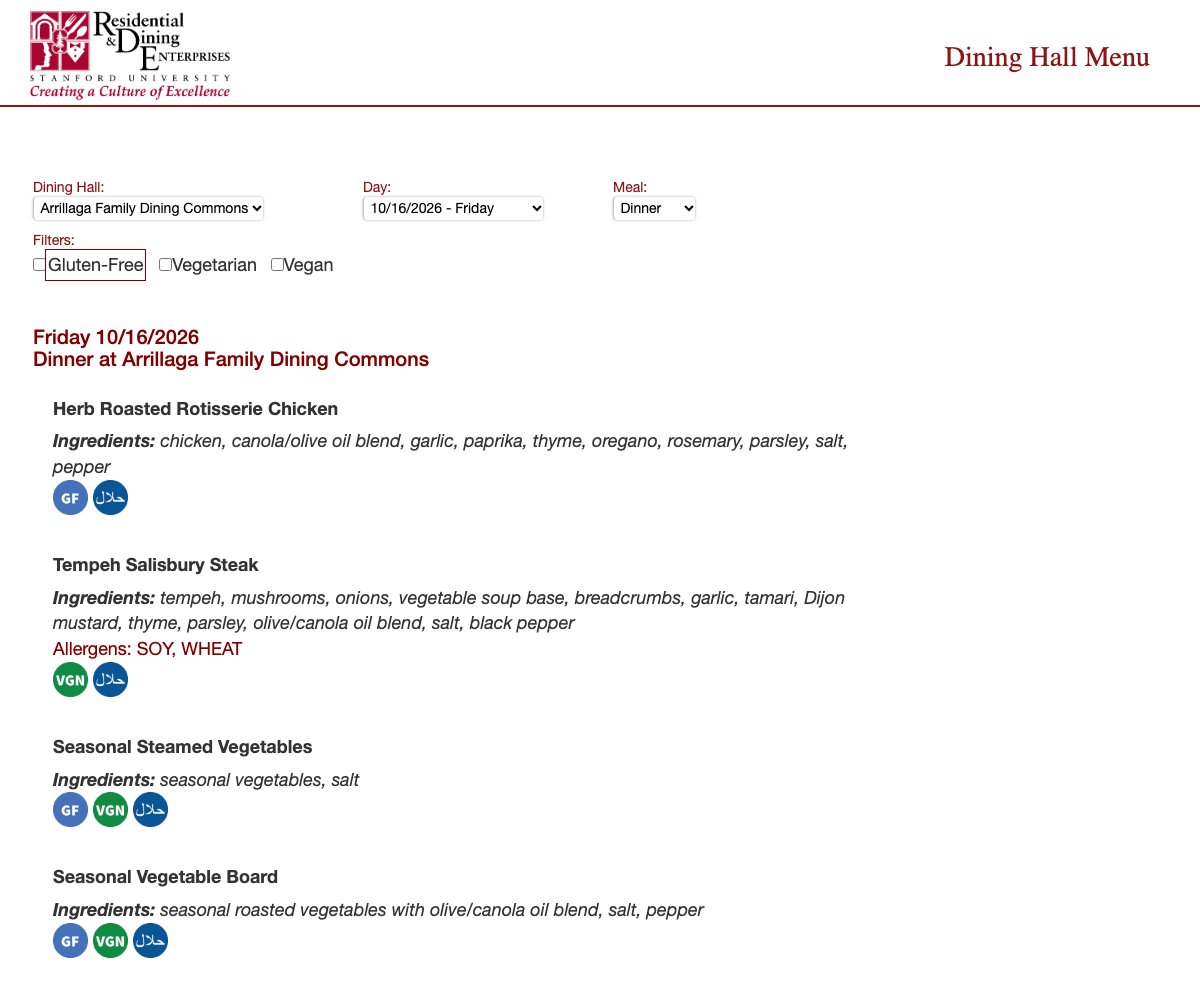 这就是斯坦福官方的菜单网站,rdeapps.stanford.edu/dininghallmenu。三个下拉框选完,出来一家食堂的一顿晚饭,这一家就有二十多道菜,一路往下滑。想看下一家?三个下拉框再来一遍。
现在都是 AI 时代了,肯定有更好的办法来查今天的菜单。我的第一想法就是用 AI 写个脚本,把每天的菜单扒下来,自己整理成一份报告,一份汇总菜单。这样我一眼就能看到今天能吃什么,然后再决定去哪个食堂。
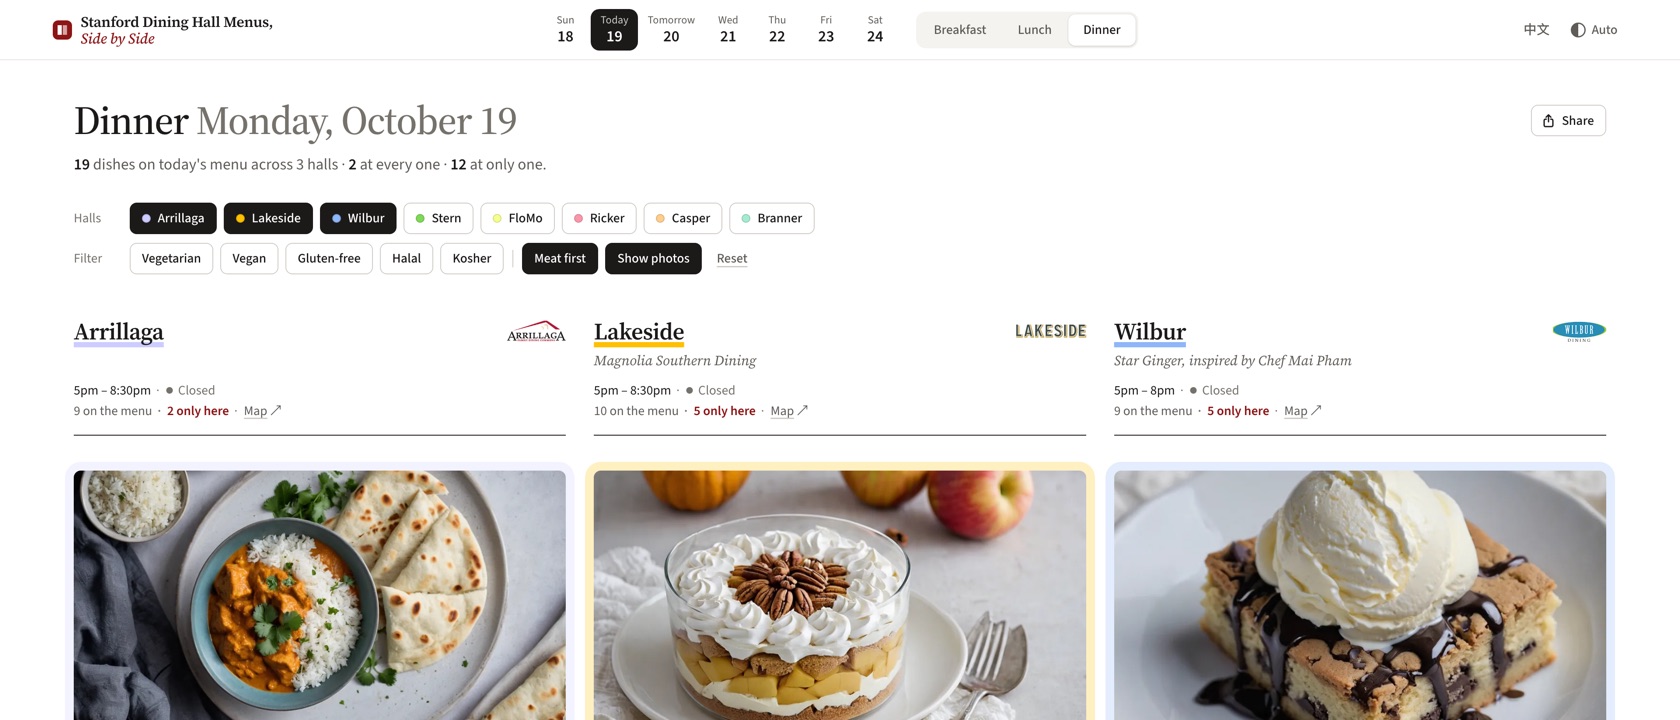
第一版做出来非常容易,巴拉巴拉就做好了:几个食堂的菜单并排放,今晚哪家有什么,一屏看完。正好我手上本来就有 neilmin.com 这个域名,开个子域名挂上去,一分钱不用多花,朋友也能用。于是就有了 stanford-dining.neilmin.com。
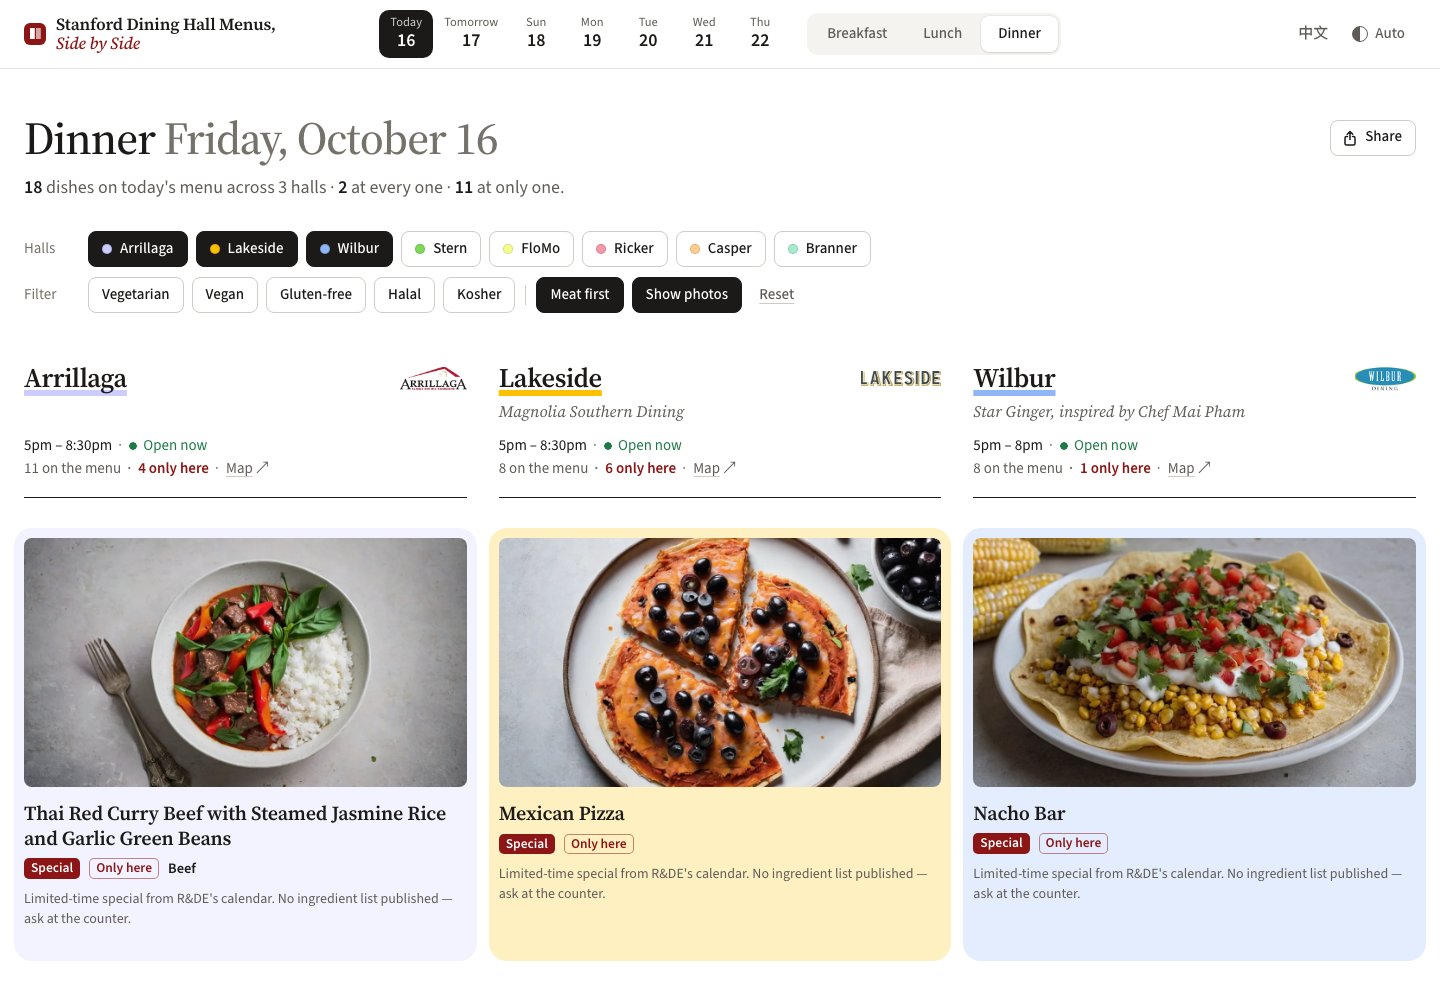 同一天的晚饭,三家并排。
做着做着又加了两样东西,中文和图。食堂的菜名是真的看不懂,“Craveable Grains”、“Magnolia Boil”,你告诉我这是啥?所以我让 AI 根据菜名和配料表,给每道菜画一张图。看一眼就知道是炖的还是炒的,是一整块肉还是切成片的。
让网站自己跑起来
第一版有个毛病:每天都得我自己动手。本地抓一下新菜单,本地画一下新菜的图,推到 GitHub 上,再等它部署。
一个号称每天自动更新的网站,背后是我每天在手动更新。这事儿说不过去。手动一周可以,一个月咬咬牙也行,时间长了肯定不行。所以得自动化。
抓菜单其实也挺折腾的。斯坦福这个网站是老 ASP.NET 那一套,你没法直接拼个网址去要"Wilbur 周五晚餐",每次请求都得带上上一次页面返回的一长串隐藏参数,这串参数还每次都变,所以只能一个请求接一个请求地排队发。烦是烦,但说到底就是个工程问题,搞定以后扔进 GitHub Actions,每天定时跑。
真正让我头疼的是生图。
生图要算力,可我不想花钱
生图这活儿是真吃算力。在我自己的笔记本上,用本地模型(RealVisXL,一个 SDXL 系的写实模型)生成一张图要一分半,画得也挺好。可一说要自动化,它就得跑在一个不是我笔记本的地方,那个地方得有算力。
那花点钱租个 GPU 不就完了?我从头到尾就没往这个方向想过,一个月五美元都没想过。这本来就是个我在本地跑一下就能解决的小事,我只是想让它自己跑起来。我不想在这件事上花一分钱。
那就找免费的。
网上搜图?菜名都是食堂自己起的,搜出来经常对不上号,版权也说不清楚,而且质量也参差不齐,看起来效果很差。然后找到了 Cloudflare 的 Workers AI,每天给一份免费额度,上面有现成的生图模型,在云上跑,不用开我的电脑。看着挺完美的。
Cloudflare 上我们用过三个生图模型:SDXL-Lightning、FLUX.1 schnell 和 FLUX.2 klein。结果画出来是这样的。左边是 Cloudflare 上的模型画的,右边是我本地的 RealVisXL 画的。
下面两组,左边是 SDXL-Lightning:
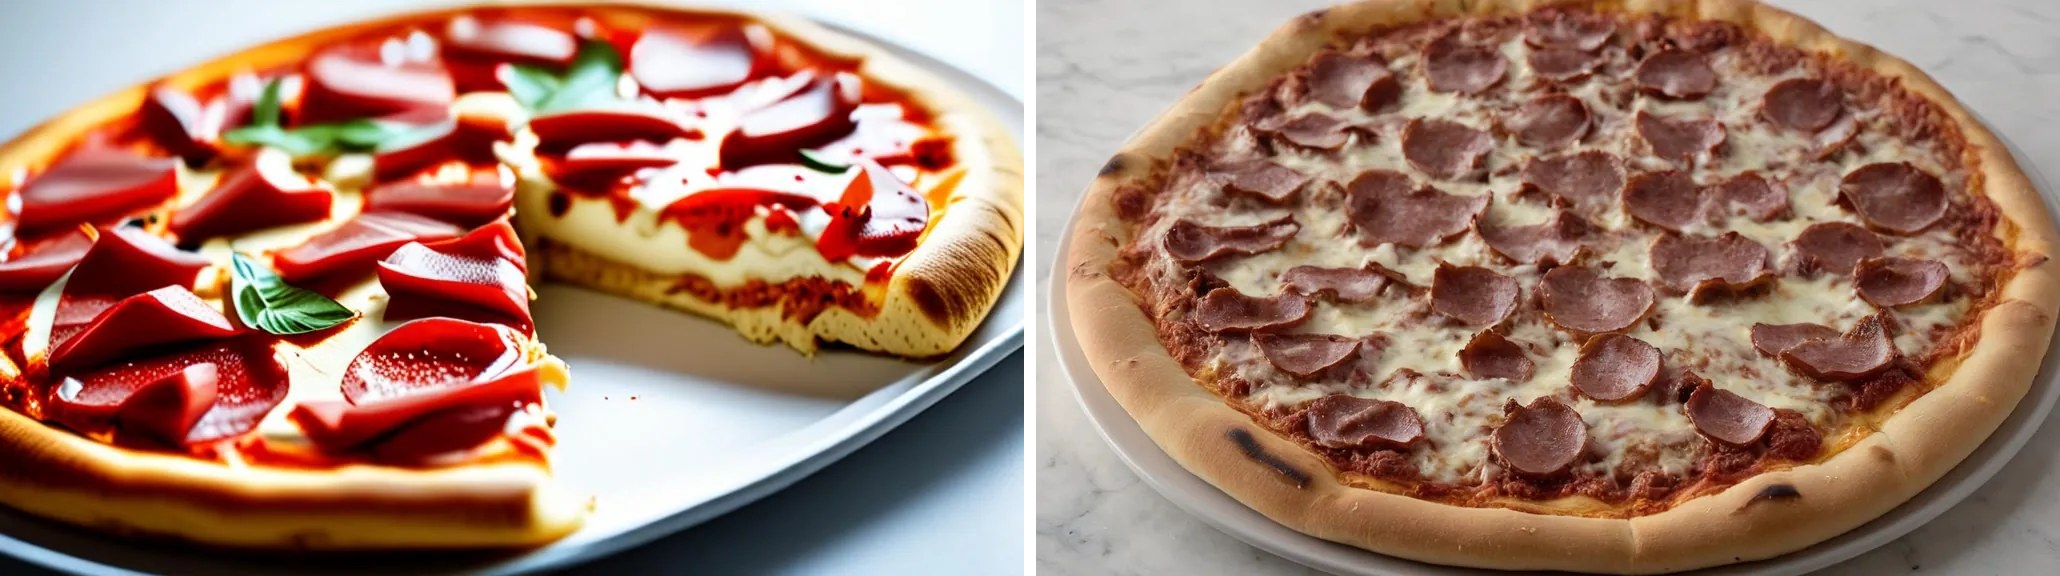 Meat Lover’s Pizza,肉食者披萨
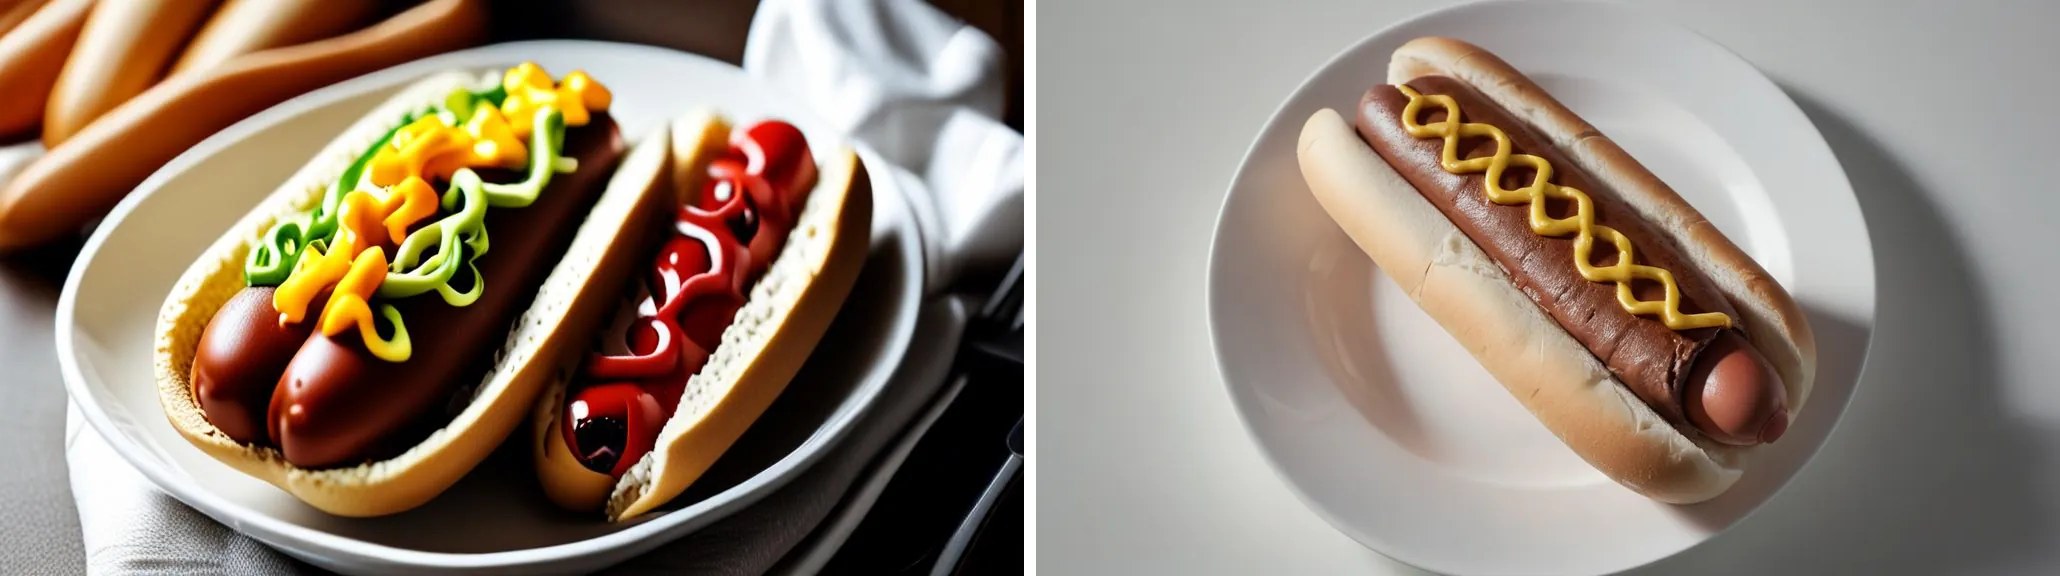 Beef Hot Dog,牛肉热狗
下面两组,左边是 FLUX.1 schnell:
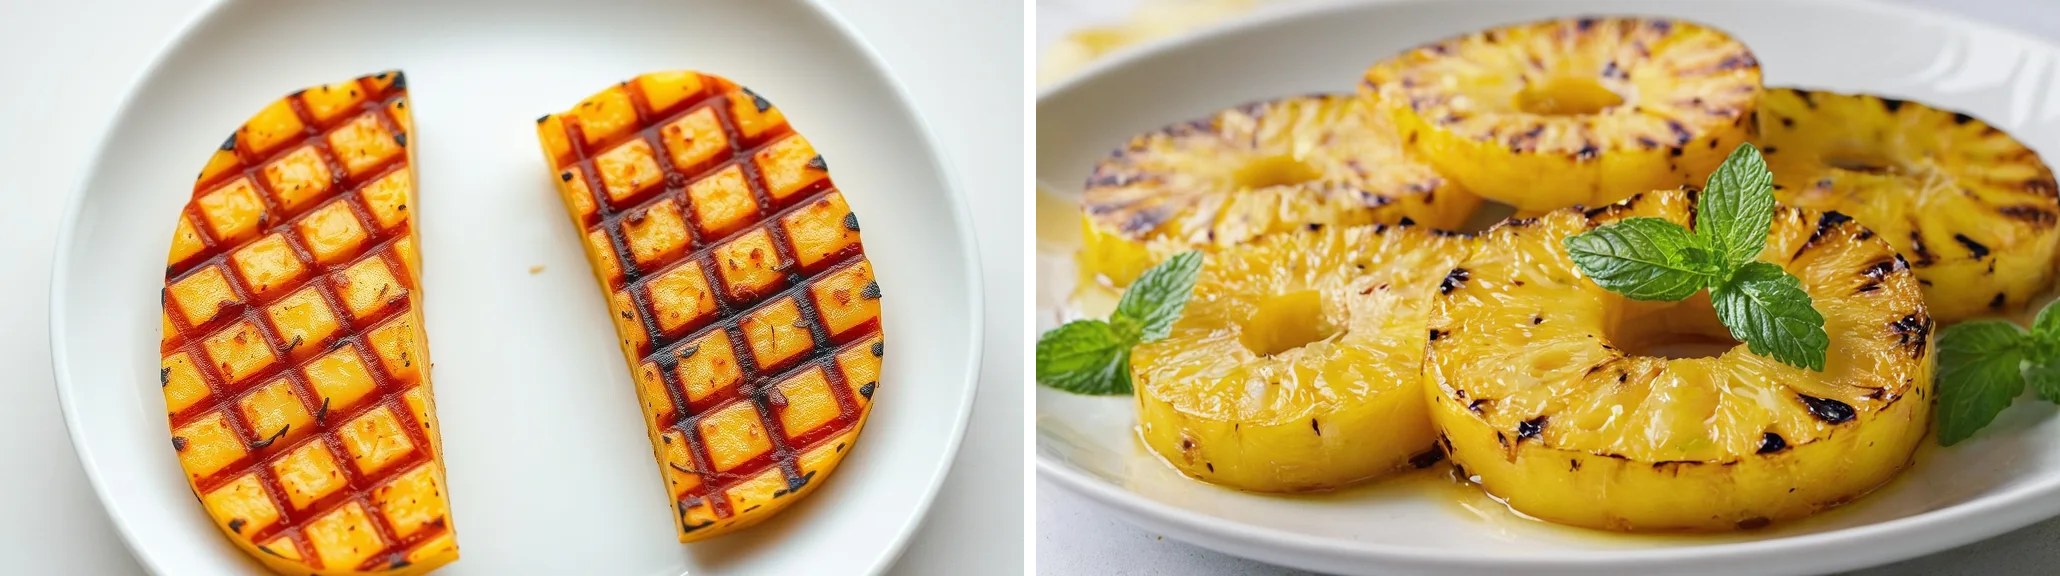 Grilled Pineapple,烤菠萝
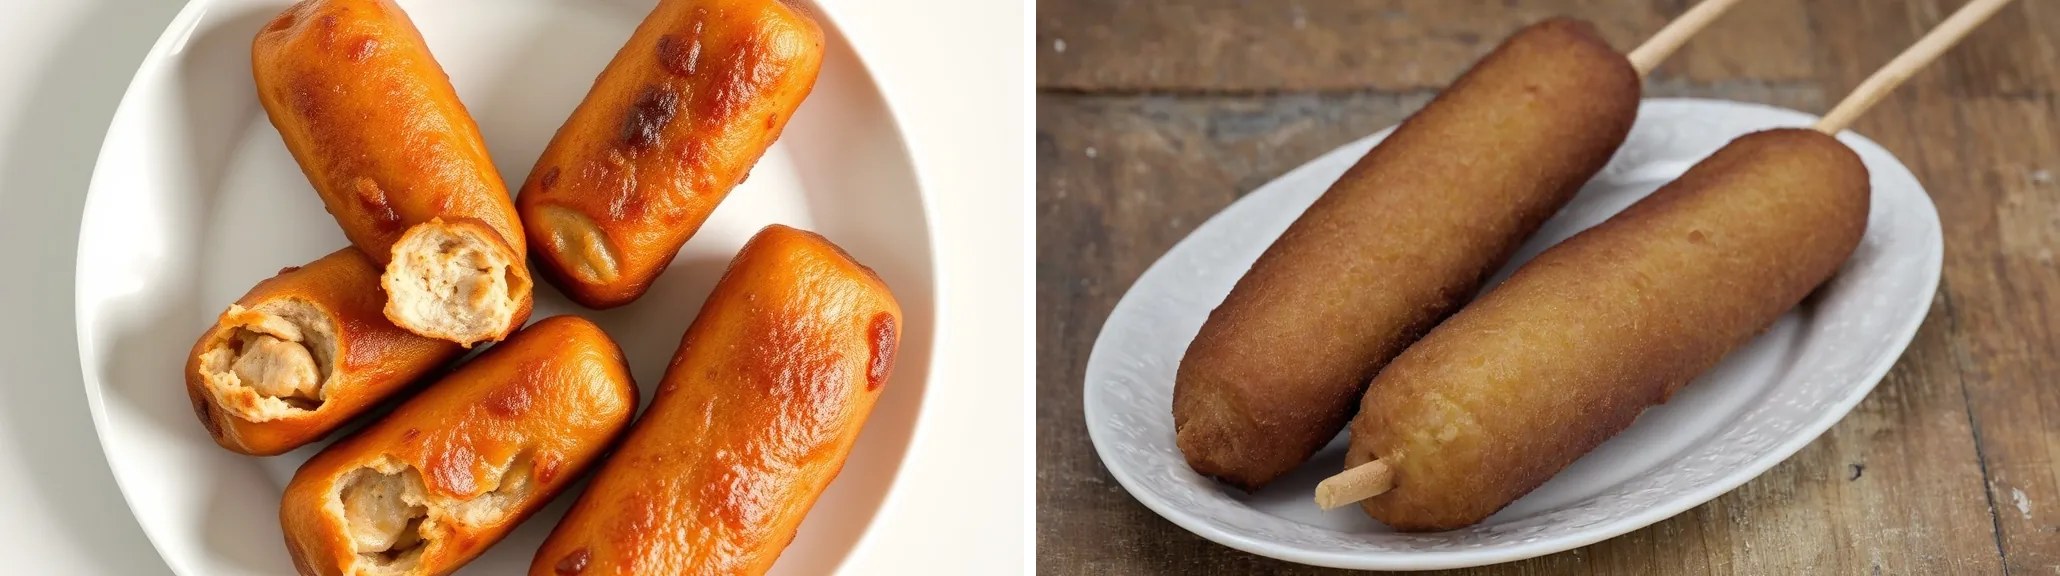 Corn Dogs,玉米热狗
我第一眼看到就一个感觉:比油画还糊,一眼 AI,像 ChatGPT-3 时代生成出来的图。中间我们也试过 FLUX.2 klein,效果也不是很好。
为了拦住这种图,我又加了一道检查:画完让另一个能看图的模型看一眼,不对就重画。想法挺好,可免费额度本来就紧,一道菜经常要画好几张才能过,画一张扣一次,看一张再扣一次,一来二去额度就没了。额度一没,检查的那个模型也看不了了。
来回折腾了好几轮,我算是想明白了:效果最好的,就是我笔记本上这个模型。模型不用换了,我就缺一个能免费跑它的地方。
GitHub Actions 也能当算力用
然后我就想到了 GitHub Actions。
平时大家用 Actions,就是代码一推上去,自动跑测试、自动部署。但你仔细想想它到底在干嘛:GitHub 借你一台 Linux 机器,按你写好的步骤跑一遍,跑完收回去。跑测试是一堆步骤,生图不也是一堆步骤吗?
而且公开仓库的 Actions 是免费的,分钟数不限。GitHub 官方文档里,公开仓库的免费机器是这个配置:
| 公开仓库的免费机器 | |
|---|---|
| CPU | 4 核 |
| 内存 | 16 GB |
| 硬盘 | 14 GB SSD |
| 显卡 | 没有 |
| 单个任务最长 | 6 小时 |
| 同时能跑 | 20 个任务(免费账号) |
没有显卡。用 CPU 跑 SDXL,一张图要 17 到 19 分钟,比我笔记本慢十几倍。说实话,这个方案我最早就想过,当时一看这速度,直接就否了。
后来有一天突然反应过来:我当时只算了一张图要多久,没算能同时开几台啊。
一台 18 分钟一张,那我就开十台一起画。每台画四个小时,十台一晚上理论上能画一百多张。食堂每天新冒出来、要配图的菜,一般也就十几二十道。够了,绰绰有余。
这大概是我做这个项目学到的最有意思的一件事。Actions 在我心里一直是跑测试、跑部署的东西,从来没想过还能把算力部署在上面。
把生图搬到 Actions 上
想法很简单,真跑起来就不是那么回事了。
先是硬盘。RealVisXL 的模型文件将近 7 GB,机器硬盘一共 14 GB,还被 GitHub 预装的一堆东西占着。.NET、Android SDK、Haskell,我一个都用不上,上来先删,给模型腾地方。然后装 CPU 版的 PyTorch 和 ComfyUI。ComfyUI 锁在跟我笔记本一模一样的版本,这样云上画出来的,就是我本地会画出来的那张。模型每次都从 Hugging Face 下载太慢,就塞进 Actions 的缓存里,反正每晚都在用,缓存一直是热的。
然后是内存。模型一跑起来就吃掉 15.3 GB,总共才 16 GB,差一点就爆了。能跑,但一点余量都没有,所以一台机器一次只能画一张。
然后是慢。既然慢,那就看看哪儿能省。我把不同设置画出来的图摆在一起,自己拿肉眼比。步数从 20 降到 12,我是真看不出区别,CPU 时间却省了五分之二。分辨率就不能动了,1024×576 跟 1344×768 放一起,前者明显差一截,所以还是跟笔记本一样用 1344×768。
还有质量。RealVisXL 虽然好,有时候画出来的还是不够好。所以我又加了一层,让另一个 AI 来审图:每画完一张,它看一眼,回答几个是非题,比如"这是一根裹着面糊的香肠吗?“有一个答错,就返工重画。实在画不对的菜就先空着,第二天晚上再试。
最后是分活儿。整个流程拆成三步:
菜单抓取跑完
    │
    ▼
plan:数一数有几道新菜,算出要开几台机器
    │
    ├──► 机器 1:画 2 道菜,AI 审图
    ├──► 机器 2:画 2 道菜,AI 审图
    │    ……
    └──► 机器 10:画 2 道菜,AI 审图
    │
    ▼
collect:把所有机器的图收回来,合并,提交
    │
    ▼
网站重新构建、部署
中间那一层用的是 Actions 的矩阵(matrix)功能。这个功能本来是拿来在几个 Python 版本上各跑一遍测试的,我拿它来分菜:plan 算出要开几台机器,矩阵就开几个并行的任务,每台领自己那一份。
分的时候,每台机器的负载要分均匀。一个任务最长只能跑 6 小时,到点 GitHub 直接把机器收走,没交上来的图就全没了。所以每台只分两道菜,画满 4 小时就不再开新的,这样所有的活儿都能在机器的有效时间里干完、交回来。
到这儿,整个自动化流水线就搭起来了。我盯了一周,每次菜单一抓完,它自己数菜、自己开机器、自己画、自己审、自己上线,我什么都不用管。
这才是一个工程师该做的:让这些东西自动跑起来,我就在旁边看着,直接验收结果。
Actions 的几个小坑
顺便说几个小坑,都不大,但第一次做的时候我确实不知道:
- 定时任务不准时。设的是几点,实际经常要晚五个小时左右才开跑。整点和半点最挤,最好错开。
- Actions 自己推上去的提交,不会触发
on: push。GitHub 故意这么设计的,怕工作流没完没了地触发自己。所以抓完菜单想自动部署,得在工作流里直接调用部署的那个工作流。 - 被触发的工作流,拉下来的可能是旧代码。它默认拿的是触发那一刻的提交,上一个工作流刚推上去的东西不在里面,所以得写明
ref: main。
这么用合规吗?
写到这儿肯定有人想:那我岂不是可以拿 Actions 当免费的云服务器?
别。GitHub 的条款写得很清楚,Actions 不能挖矿,不能当 CDN 或者无服务器后端,也不能干跟这个仓库无关的事,只能用在这个项目自己的开发、测试、部署和发布上。我们这么用勉强算是合理,做的都是跟这个项目有关的资源:画出来的图就是这个网站的内容,提交在这个仓库里,跟着网站一起发布。
不花钱的代价
代价也有,就两条。
一是慢。一张图十几分钟,一道新菜从出现在菜单上到有图,得等好几个小时。但食堂的菜单本来就提前一周放出来,等它真上桌,图早就画好了。我专门拿数据查了一下,10 月以后新出现的 409 道菜里,有 406 道在第一次上桌当天或者之前就有图了。
二是量有上限。能同时开几台、每台能跑多久、每天有多少免费额度,都是定死的。哪天心血来潮想把一千多道菜全部重画一遍,那是不可能的。真碰上一大批新菜,比如开学第一周,我就在笔记本上跑,一分半一张,一会儿就清完了。
这两条对一个食堂菜单网站来说根本不是事儿。它不需要秒出图,也不需要无限画,每天把那几道新菜画对就行。
上线一个月,五百多人用过
自从这个网站上线之后,我一直在跟踪它的使用情况。上线一个月,一共有五百多人用过,现在每天有五六十个人在用。
最让我开心的是,最近一周每天来看菜单的人里,大概七成以前来过。说明大家是真的把它当成了每天看菜单的工具。
很高兴能在看食堂菜单这件事上,给大家做了一点微小的工作。